Het Probleem Dat U Kent
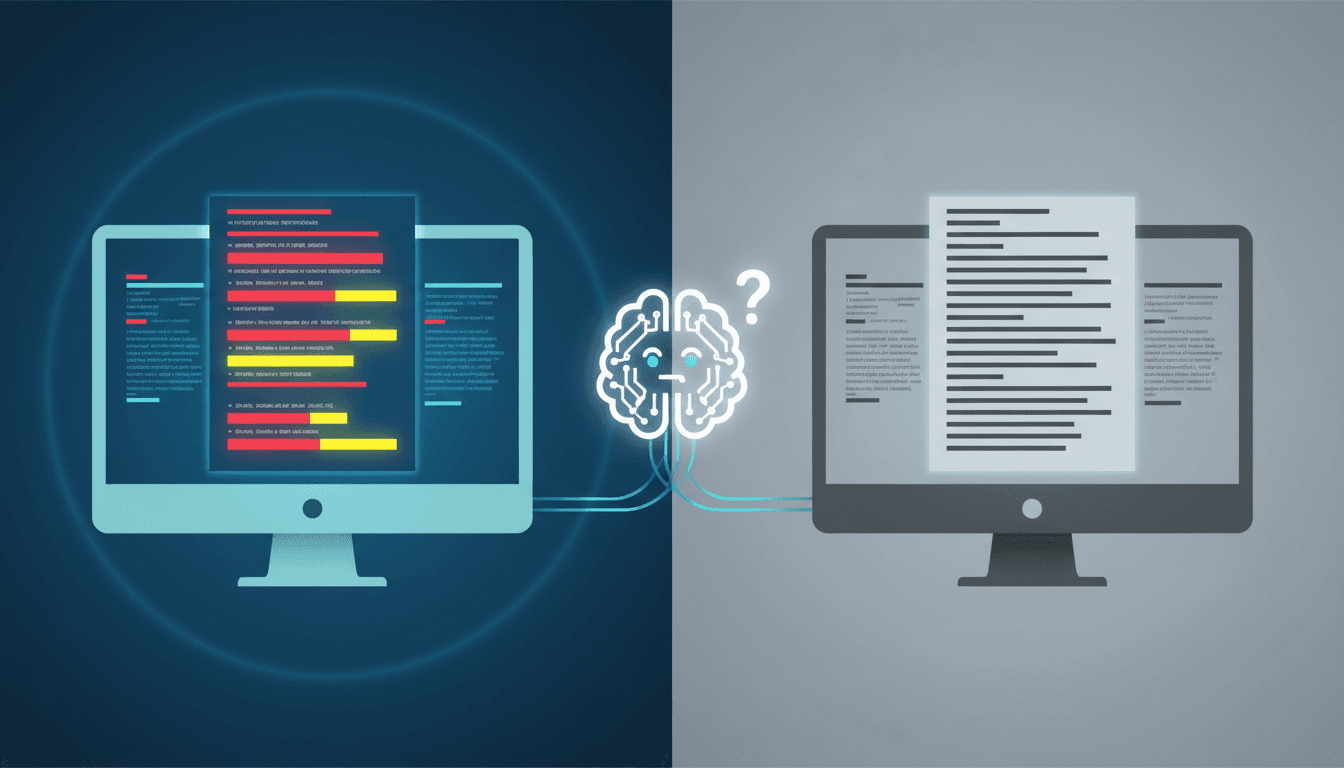
Uw AI-agent werkt perfect in de testomgeving. Vervolgens hernoemt de marketingafdeling 'Verzenden' naar 'Verzoek indienen' of de API-team verandert 'gebruiker_id' in 'accountId'. De agent stopt. Ondersteuningsaanvragen nemen toe. De taak is niet veranderd. Het interface wel.
Dit is een veelvoorkomend productieprobleem. AI-agents worden vaak getraind of aangezet om exacte woorden, labels en schema's te volgen. Wanneer deze labels veranderen, kan de agent het punt missen. Voor uw team betekent dit broze automatisering, onverwachte fouten en handmatige schoonmaak.
Wat Onderzoekers Ontdekten
Het paper One Task, Many Interfaces: Simple Cross-Interface Consistency Training Improves LLM Agent Robustness bestudeert een eenvoudige foutmodus: een AI-agent kan de taak kennen, maar toch falen wanneer het interface verandert. Denk aan een kassamedewerker die getraind is op een kassa die 'Verkoop annuleren' zegt. Als de nieuwe kassa 'Transactie annuleren' zegt, kan de kassamedewerker bevriezen. De taak is identiek. Het label is anders.
Onderzoekers vonden dat post-training - de laatste trainingsstap die een basismodel aanpast aan uw taken - een agent's vaardigheid kan binden aan het exacte interface dat het tijdens de training zag. Oppervlakteveranderingen die de betekenis hetzelfde houden - het hernoemen van een actie, het veranderen van notatie, het wisselen van API-veldnamen - kunnen de agent nog steeds slechter maken. Dit is belangrijk omdat uw product constant verandert. U kunt niet elke knop, schema en prompt bevriezen om de AI-stabiliteit te behouden.
Het paper waarschuwt ook dat het toevoegen van meer voorbeelden niet altijd voldoende is. Als u traint op 100 willekeurige interfaces, maar elke sample afzonderlijk beoordeelt, kan de agent nog steeds falen op een nieuwe interface. Het leert patronen te kopiëren, niet om te zien dat de taak hetzelfde is onder de oppervlakte. De voorgestelde oplossing is Cross-Interface Consistency Training: train het model om equivalente antwoorden te geven over verschillende interfaces voor dezelfde taak.

Hoe U Dit Vandaag Kunt Toepassen
U heeft geen volledig onderzoekslaboratorium nodig om dit praktisch te maken. Gebruik deze stappen deze week.
- Bouw een interface-robustheidstest-suite.
Neem uw top10agenttaken. Voer elke taak uit via drie interfacevarianten: hernoemde knop, gewijzigd API-veld en alternatieve notatie. Voorbeeld: als de taak 'ondersteuningsaanvraag maken' is, test 'Ticket openen', 'Probleem maken' en 'Geval loggen'. Noteer geslaagd/mislukt en latentie. Dit geeft u een meetbare basislijn. Teams die deze stap toevoegen, kunnen regressies vangen voordat ze worden geïmplementeerd, in plaats van na klantklachten. Dit kost ongeveer 2 tot 3 dagen voor één engineer.
- Maak een bedrijfsactiemappinglaag.
Laat de agent niet afhankelijk zijn van raw UI-labels. Definieer stabiele interne acties: ticket.maken, klant.notificeren, factuur.verzenden. Kaart vervolgens interfacevarianten naar die acties. Als uw toolschema 'e-mail verzenden' zegt, 'gebruiker notificeren' of 'bericht verzenden', vertelt uw mappinglaag de agent dat ze allemaal klant.notificeren betekenen. Dit vermindert het opnieuw trainen wanneer productnamen veranderen.
- Voeg gepaarde interfacevoorbeelden toe aan prompts of fine-tuning.
Voor elke taak, voeg minstens twee equivalente interfacevoorbeelden toe. Prompt: 'Wanneer het interface zegt Transactie annuleren of Verkoop annuleren, voer dezelfde actie uit: bestelling annuleren.' Als u fine-tuned, voeg paren toe waar de taak identiek is, maar labels verschillen. Dit leert consistentie. Begin klein: 50 gepaarde voorbeelden voor uw hoogste-risicoworkflow kunnen voldoende zijn voor een eerste test.
- Randomiseer interface-labels in testing, niet alleen in demos.
Voordat u releaset, voert u dezelfde taak uit via gerandomiseerde labels, veldnamen en notatie. Gebruik tools zoals pytest, GitHub Actions of uw interne eval-harness. Maak de test mislukken als de agent het gedrag verandert voor een semantisch identieke taak. Dit maakt robuustheid tot een releasepoort.
- Bewaak agentensucces per interfaceversie.
Volg niet alleen de algehele nauwkeurigheid. Volg succes per toolnaam, API-versie en UI-label. Voorbeeld: ticket.maken werkt met 94% met 'Verzenden', maar alleen 71% met 'Verzoek indienen'. Dat vertelt u waar u de mapping of prompt moet repareren. U krijgt een duidelijke prioriteitenlijst in plaats van gokken.

Waar U Op Moet Letten
Deze benadering helpt bij oppervlakteveranderingen, niet bij elk probleem. Als de taak zelf ambigu wordt, kan de agent nog steeds falen. U kunt gelabelde equivalente interfaces nodig hebben, wat tijd kost. Ook consistency training of mappinglagen behoeven onderhoud. Als uw productteam acties vaak hernoemt, moet uw mapping up-to-date blijven. Ten slotte geeft het paper niet genoeg details voor exacte modelgrootte, compute-kosten of universele nauwkeurigheidswinsten. Behandel het als een ontwerpprincipe en meet het op uw eigen stack.
Uw Volgende Stap
Begin door een vijf-gevallen interface-robustheidstest te bouwen voor uw meest belangrijke agentworkflow. Hernoem één label, verander één API-veld en wissel één notatie. Als de agent faalt, voeg een mappinglaag toe vandaag. Probeer dit deze week: maak één stabiele interne actie, kaart twee interfacevarianten naar die actie en voer een geslaagd/mislukt-test uit. Deel uw geslaagde percentage in de comments - welke interfaceverandering brak uw agent als eerste?
Reacties
Loading...